En resumen
Qué se comprueba
el código de estado HTTP, el bloqueo en robots.txt, la etiqueta meta robots con noindex y la validez del sitemap XML.
Cuándo falla
cuando la URL redirige o devuelve error, cuando robots.txt la bloquea, cuando lleva noindex o cuando el sitemap no es válido.
Por qué importa
Google documenta que no indexa las URLs que devuelven error 4xx y que elimina del índice las que ya tenía.
Severidad en Wakaris
Crítico. Falla solo en el 0,5 % de las páginas analizadas, pero cuando falla la página no existe para el buscador.
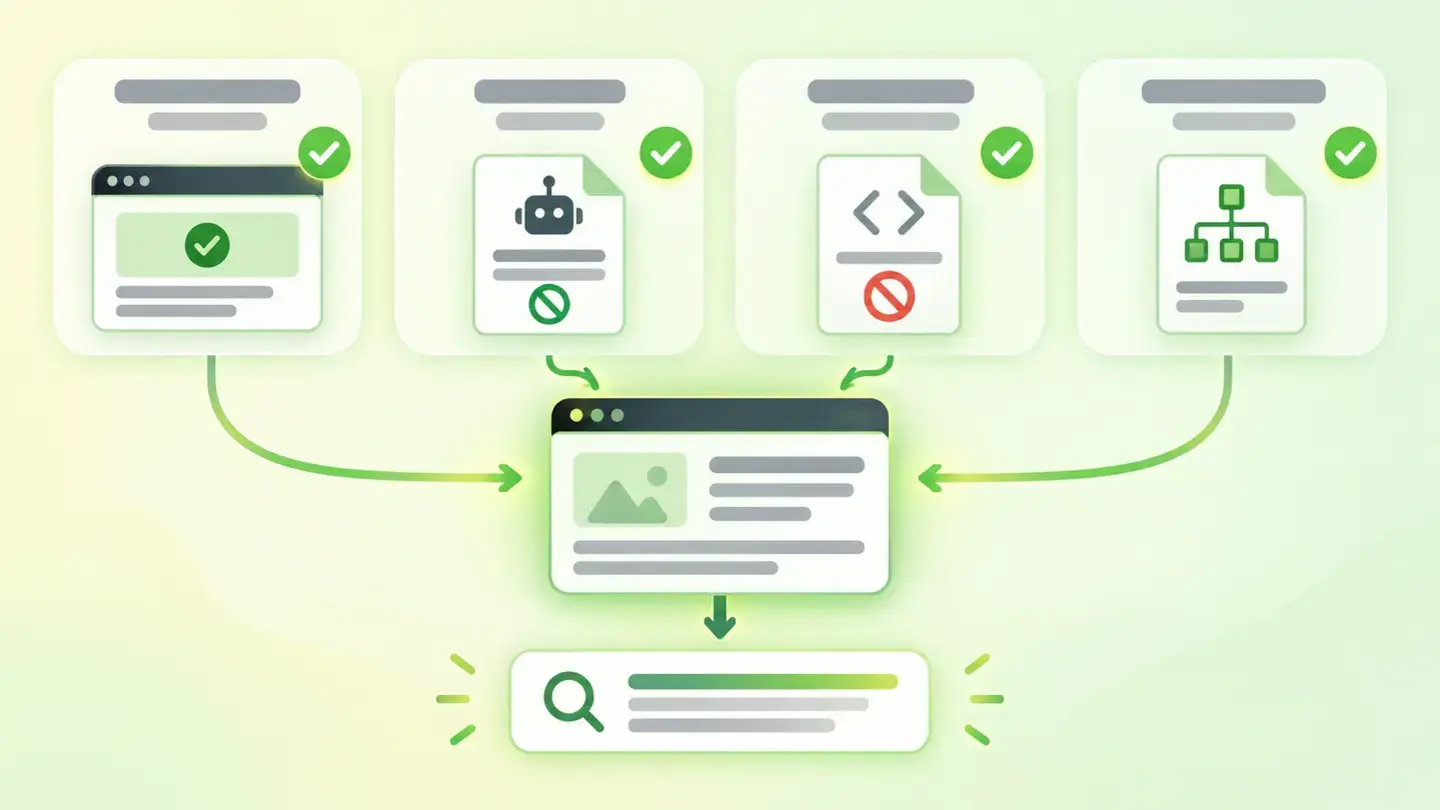
Qué es y qué comprueba este hallazgo
Este hallazgo salta cuando la página no cumple alguna condición que el buscador necesita para incluirla en su índice, la lista de páginas que conoce y puede mostrar. Lo que no está en él no se posiciona.
Wakaris revisa cuatro cosas. La primera es el código de estado HTTP, la respuesta numérica del servidor: 200 significa que sirve la página, 3xx que redirige, 4xx que no la encuentra o la prohíbe y 5xx que ha fallado. La segunda es el bloqueo en robots.txt, el archivo en la raíz del dominio que dice a los rastreadores qué rutas pueden pedir. La tercera es la etiqueta meta robots con valor noindex, que pide al buscador que no guarde la página. La cuarta es que el sitemap XML, el listado de URLs que se ofrece a los buscadores, exista y sea válido. Basta con que una de las cuatro falle para que la indexabilidad quede comprometida.
Cómo se comprueba
Wakaris pide la URL que le indiques igual que lo haría un rastreador y registra qué ocurre en las cuatro condiciones, sin instalar nada. El informe te dice qué código de estado devolvió el servidor, si la ruta está bloqueada en robots.txt, si la página lleva noindex y si el sitemap XML existe y está bien formado. Cada condición es una evidencia separada, con la URL y el fragmento de código que la respalda.
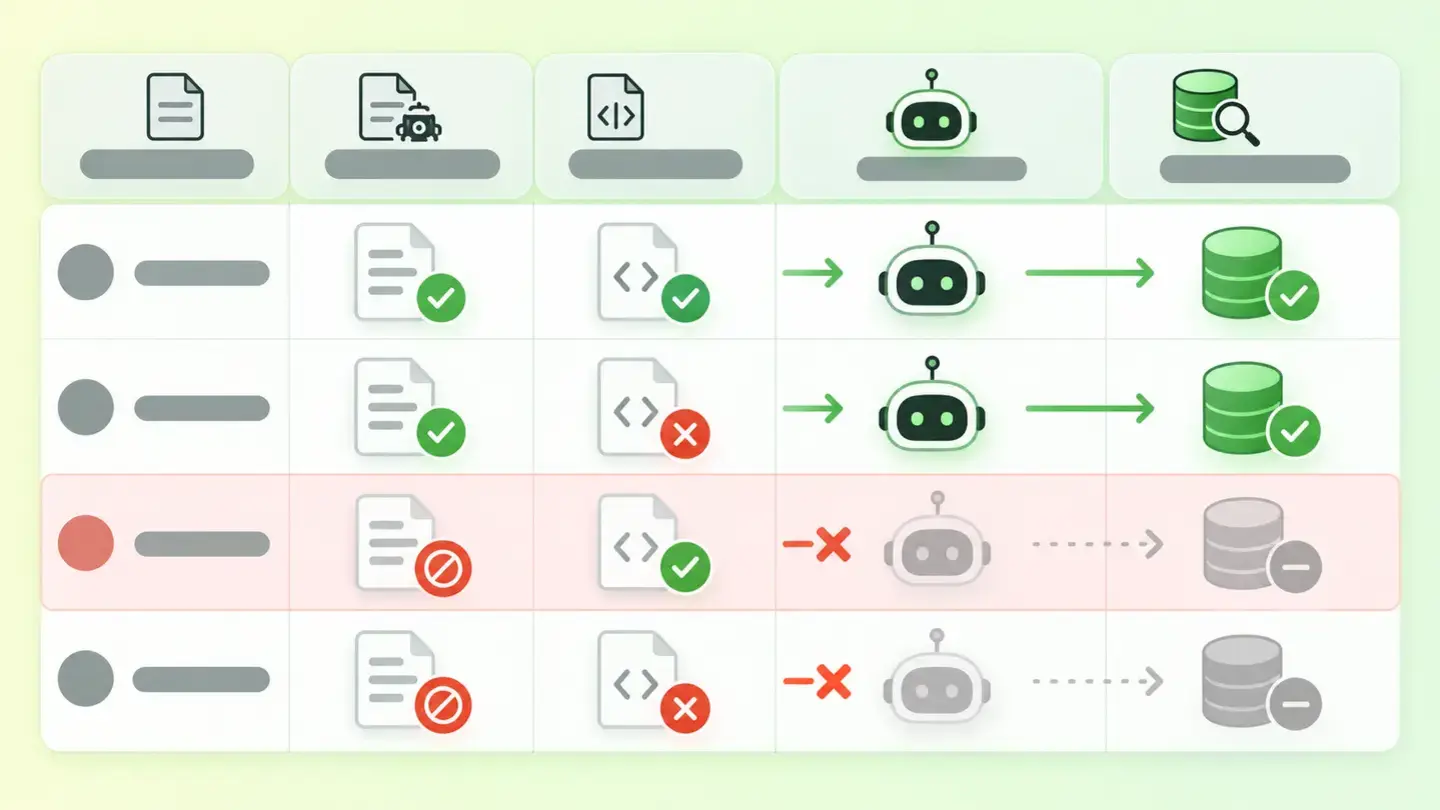
Conviene entender por qué se miran las cuatro juntas. Google documenta que robots.txt no es un mecanismo para mantener una página fuera de su buscador: una URL bloqueada puede indexarse igual si otros sitios la enlazan. Y documenta lo contrario para noindex: para que la etiqueta funcione, la página no puede estar bloqueada en robots.txt, porque si el rastreador no puede entrar nunca verá la instrucción. Un ajuste que parece correcto visto solo puede anular otro. Y la comprobación es sobre una URL concreta: la portada puede estar bien y una ficha de producto, no.
Por qué importa
Es un problema binario: una página no indexable no pierde posiciones, pierde la posibilidad de tener alguna.
Google es explícito con los códigos de estado. No indexa las URLs que devuelven un código 4xx, y las que ya tenía indexadas y empiezan a devolverlo se eliminan del índice. Con los errores 5xx el efecto es más lento pero acaba igual: los rastreadores frenan, y las URLs ya indexadas se conservan un tiempo y terminan cayendo. Con las redirecciones, Google sigue hasta 10 saltos, pero procesa el contenido del destino, no el de la URL pedida.
El otro frente es el de las instrucciones. Un noindex heredado de la versión de pruebas, o un Disallow demasiado amplio en robots.txt, puede dejar fuera del buscador secciones enteras sin que nadie lo note, porque la web se ve bien en el navegador. Ese es el rasgo peligroso del hallazgo: todo funciona para las personas y nada para el buscador. Por eso en Wakaris tiene severidad Crítico aunque sea poco frecuente: cuando ocurre, el resto de mejoras no sirve para nada.
Causas comunes
La causa más repetida es un noindex que se quedó de la etapa de desarrollo. Los entornos de pruebas se marcan con noindex, y al publicar nadie retira la etiqueta, o el gestor de contenidos mantiene marcada la opción de pedir a los buscadores que no indexen el sitio.
La segunda es un robots.txt demasiado generoso con el Disallow: bloquear una carpeta entera para ocultar unos archivos internos deja fuera también las páginas que cuelgan de ella. Google documenta que sin robots.txt se permite todo: el problema nunca es que falte, sino que prohíba de más.
La tercera son los códigos de estado: páginas que se movieron y ahora redirigen en cadena, URLs antiguas que devuelven 404 pero siguen enlazadas, o un servidor que responde 5xx bajo carga justo cuando pasa el rastreador.
La cuarta es el sitemap: un archivo con URLs relativas, sin UTF-8 o por encima de los 50 MB o las 50.000 URLs que Google fija por archivo. No bloquea la indexación, pero quita al buscador la lista que le ayuda a descubrir tus páginas.
Cómo solucionarlo
Empieza por el informe de Wakaris, que te dice cuál de las cuatro condiciones falla, porque el arreglo es distinto en cada caso.
Si es el código de estado, haz que la URL responda 200 directamente: apunta las redirecciones encadenadas al destino final, corrige los enlaces a páginas que devuelven 404 y revisa con quien gestione el servidor los errores 5xx.
Si es robots.txt, acota los Disallow a lo que de verdad quieres ocultar; Google documenta que una regla Allow puede anular un Disallow más amplio para una ruta concreta.
Si es noindex, retíralo de la etiqueta meta robots o de la cabecera X-Robots-Tag de las páginas que sí quieres en el buscador, y comprueba que no estén además bloqueadas en robots.txt, porque entonces la instrucción ni se leerá.
Si es el sitemap, genera uno con URLs absolutas, en UTF-8 y dentro de los límites, y declara su ruta en robots.txt con una línea Sitemap:. Después vuelve a pasar la URL por Wakaris para confirmar que las cuatro condiciones quedan limpias.
Tabla que cruza las dos instrucciones, Disallow en robots.txt y noindex en la página, y muestra que una página bloqueada nunca llega a leer su noindex
Brief para generar la imagen
Ilustración editorial para una guía técnica de Wakaris.
Tema: Tabla que cruza las dos instrucciones, Disallow en robots.txt y noindex en la página, y muestra que una página bloqueada nunca llega a leer su noindex.
Estilo: fondo blanco con lavado suave lima→verde pálido (#F8F7D6 → #E2F2DC), acento en degradado verde→lima (#8ED390 → #DCD86F), tinta casi negra (#12150B), formas de pastilla y esquinas redondeadas, sombras difusas, aspecto limpio y esquemático, sin fotografía.
Formato: 16:9, 1440 píxeles de ancho.
Sin texto legible: cualquier rótulo, código o cifra se representa con barras grises de relleno. El significado lo lleva el pie de foto, no la imagen.
Sin logotipos reales ni marcas de terceros. Sin personas reconocibles.
Etiquetas: indexabilidad, tabla, cruza, instrucciones, disallow, robots, txt, noindex
Pregúntale a tu IA
Si quieres profundizar en tu caso concreto, copia uno de estos dos prompts y pégalo en la IA que uses. Elige según tu situación.
Ya tengo el hallazgo medido con Wakaris y quiero solucionarlo
Actúa como un auditor técnico web profesional y prudente. Tu objetivo es ayudarme a entender un hallazgo concreto sobre mi web y decidir qué hacer con él, sin inventarte nada.

Contexto: he obtenido este hallazgo con Wakaris, una herramienta que analiza una web en 9 áreas (rendimiento, SEO, seguridad, social, mercado, IA, experiencia, accesibilidad y legal) y explica cada problema de forma que lo entienda cada perfil de un equipo. El hallazgo es: Indexabilidad. Mi página no cumple alguna de las condiciones para entrar en el índice de Google: el servidor no la sirve con código 200 (redirige o da error), robots.txt la bloquea, lleva la etiqueta noindex o el sitemap XML no es válido. Referencia: la URL debe responder 200, no estar bloqueada en robots.txt, no llevar noindex y figurar en un sitemap válido, con URLs absolutas y en UTF-8.

Pega aquí el resultado de Wakaris: qué condición falla (código de estado, robots.txt, noindex o sitemap), con qué valor y en qué página. Si no lo tienes, dímelo y te diré cómo obtenerlo antes de seguir.

Reglas que debes seguir en todo momento:

1. No asumas nada sobre mi web. Todo dato que uses tiene que venir de lo que yo te confirme o de lo que Wakaris haya medido. Si no lo sabes, pregúntamelo antes de afirmarlo.
2. Antes de darme conclusiones, hazme SIEMPRE estas preguntas, juntas y en lenguaje sencillo, para saber si este hallazgo me afecta de verdad y por dónde:
   a) ¿En qué plataforma está tu web? (WordPress, Shopify, web a medida, otra)
   b) ¿Qué condición ha fallado: el código de estado, el bloqueo en robots.txt, la etiqueta noindex o el sitemap? Si son varias, dime cuáles.
   c) ¿La página afectada es una que quieres que aparezca en Google, o es una página interna, de pruebas o de administración?
   d) ¿La web ha pasado hace poco por una migración, un cambio de dominio o una publicación desde un entorno de pruebas?
   e) ¿Sabes si tu gestor tiene activada alguna opción del tipo "pedir a los buscadores que no indexen este sitio"?
   f) ¿Controlas el servidor o el hosting, o es un servicio gestionado?
   g) Si hay que aplicar un arreglo técnico, ¿lo harías tú, un técnico interno o una agencia?
3. Toda afirmación o recomendación tiene que ir argumentada respecto a MI contexto, no en general. Si me recomiendas algo, explícame por qué aplica a mi caso.
4. Marca siempre tu nivel de certeza. Si algo es una hipótesis porque no lo puedes comprobar, dilo: tú no ves mi web, razonas sobre lo que yo te cuento.
5. No me propongas cambios técnicos irreversibles o de riesgo (editar robots.txt a ciegas, tocar redirecciones del servidor, cambios directos en producción) sin avisarme antes del riesgo y de que conviene una copia de seguridad o un entorno de prueba.
6. Si necesitas un dato que solo se obtiene comprobando la web (confirmar el código de estado real, el contenido de robots.txt, o si el arreglo funcionó), dímelo y recomiéndame volver a pasar la página por Wakaris: eso se comprueba, no se adivina.
7. La decisión final es mía, no tuya. Tu papel es ayudarme a entender y a preparar la acción, no decidir por mí.
8. Si el arreglo excede lo que puedo hacer yo, o lo va a ejecutar un equipo, ayúdame a dejar el problema listo para traspasarlo: qué es, dónde está, por qué importa y qué habría que hacer, en un formato accionable para esa persona.

Fuente de este hallazgo: https://www.wakaris.com/es/guias/seo-tecnico/indexabilidad
Para comprobarlo o volver a comprobarlo: https://www.wakaris.com/

Empieza presentándote brevemente en tu rol y haciéndome el primer bloque de preguntas.
Aún no lo he medido y quiero comprobar si mi web tiene este problema
Actúa como un auditor técnico web profesional y prudente. Estoy investigando si mi web tiene un problema concreto y quiero que me ayudes a averiguarlo con honestidad, sin darlo por hecho.

Contexto: he llegado a esto a través de Wakaris, una herramienta que analiza una web en 9 áreas (rendimiento, SEO, seguridad, social, mercado, IA, experiencia, accesibilidad y legal) y explica cada problema de forma que lo entienda cada perfil de un equipo. El problema que quiero investigar es: Indexabilidad. Consiste en que una página no puede entrar en el índice de Google porque el servidor no la sirve con código 200, porque robots.txt la bloquea, porque lleva la etiqueta noindex o porque el sitemap XML no es válido. Todavía NO sé si mi web lo tiene: quiero averiguarlo.

Reglas que debes seguir en todo momento:

1. Lo primero y más importante: esto se COMPRUEBA pidiendo la página como lo haría un rastreador, y tú no puedes hacerlo desde esta conversación. Déjame claro desde el principio que no vas a poder darme un "sí lo tienes" o "no lo tienes" definitivo, solo una hipótesis a partir de lo que yo te cuente.
2. No asumas nada. Antes de darme ninguna valoración, hazme SIEMPRE estas preguntas, juntas y en lenguaje sencillo, para estimar si es probable que tenga el problema:
   a) Si buscas en Google el nombre de tu web o una frase exacta de una de tus páginas, ¿aparece?
   b) ¿La web se publicó hace poco, o ha cambiado de dominio, de plataforma o de estructura de direcciones recientemente?
   c) ¿Hubo una versión de pruebas o de desarrollo antes de publicarla?
   d) ¿Alguien ha tocado alguna vez el archivo robots.txt o una opción de "visibilidad para buscadores" en el gestor?
   e) ¿Tienes páginas antiguas que ya no existen pero siguen enlazadas desde otras?
   f) ¿En qué plataforma está la web? (WordPress, Shopify, web a medida, otra; o no lo sé)
3. Con mis respuestas, dame una estimación clara de si es PROBABLE o POCO PROBABLE que lo tenga, y de cuál de las cuatro condiciones sería la sospechosa, argumentada según lo que te he dicho y marcada explícitamente como hipótesis, no como diagnóstico.
4. Dime de forma directa que la única manera de saberlo de verdad es comprobarlo, y que puedo hacerlo gratis y sin crear cuenta pasando mi web por Wakaris, que me dará el código de estado real, el resultado de robots.txt, noindex y sitemap, y de paso el estado de las otras áreas.
5. Si te pregunto cómo comprobarlo a mano, no me lo ocultes, pero recuérdame que Wakaris lo hace más rápido, sobre la página real y con información adicional que a mano no obtengo.
6. Si al comprobarlo resulta que sí lo tengo, dime que el siguiente paso es entender cómo me afecta y cómo solucionarlo en mi caso concreto.
7. La conclusión y la decisión son mías, no tuyas. Tú me ayudas a orientarme.

Fuente de este hallazgo: https://www.wakaris.com/es/guias/seo-tecnico/indexabilidad
Para comprobarlo: https://www.wakaris.com/

Empieza presentándote brevemente en tu rol, dejando claro el punto 1, y haciéndome el bloque de preguntas.
Preguntas frecuentes
¿Basta con bloquear una página en robots.txt para que no salga en Google? +
No. Google documenta que robots.txt no es un mecanismo para mantener una página fuera del buscador: si otros sitios la enlazan, puede indexarse igual aunque esté bloqueada. Para sacarla del índice hay que usar noindex o protegerla con contraseña, y dejar que el rastreador pueda entrar a leer la instrucción.
¿Qué diferencia hay entre noindex y Disallow? +
Disallow, en robots.txt, impide que el rastreador pida la página. noindex, en la etiqueta meta robots o en la cabecera X-Robots-Tag, le deja entrar pero le pide que no la guarde. No se suman: si la página está bloqueada, el rastreador nunca verá el noindex y la URL puede seguir apareciendo.
¿Mi web necesita un sitemap? +
Depende del tamaño y del enlazado. Google indica que una web de unas 500 páginas o menos y bien enlazada internamente puede no necesitarlo. Ayuda a descubrir URLs, sobre todo en sitios grandes, nuevos o con poco enlace externo, pero no garantiza que todo lo que contiene se rastree e indexe.
¿Una redirección cuenta como fallo de indexabilidad? +
Wakaris la registra porque la URL analizada no responde 200, sino que envía a otra. Google sigue hasta 10 saltos y trata una redirección 301 como una indicación fuerte de que debe procesar el destino, así que una sola redirección bien hecha no es grave. Las cadenas largas y las redirecciones temporales que deberían ser permanentes, sí.
Fuentes citadas
- developers.google.comIntroduction to robots.txt, Google Search Central: robots.txt no es un mecanismo para mantener una página fuera de Google; una URL bloqueada puede indexarse si otros sitios la enlazan.
- developers.google.comHow to write and submit a robots.txt file, Google Search Central: ubicación en la raíz del host, significado de Disallow y Allow, y permiso total sin robots.txt.
- developers.google.comBlock Search indexing with noindex, Google Search Central: sintaxis de meta robots y X-Robots-Tag; noindex solo funciona si la página no está bloqueada en robots.txt.
- developers.google.comHTTP status codes, and network and DNS errors, Google Search Central: tratamiento de 2xx, 3xx, 4xx y 5xx, y los 10 saltos de redirección.
- developers.google.comLearn about sitemaps, Google Search Central: cuándo hace falta un sitemap y que no garantiza la indexación.
- developers.google.comBuild and submit a sitemap, Google Search Central: límites de 50 MB y 50.000 URLs, UTF-8, URLs absolutas y la línea Sitemap en robots.txt.
Actualizado: 7 de septiembre de 2026.
Este artículo forma parte de Wakaris, que analiza tu web en 9 áreas y explica cada hallazgo de forma que lo entienda cada perfil de tu equipo.