En resumen
Qué se comprueba
que robots.txt, la meta robots, la cabecera HTTP y la etiqueta canónica digan lo mismo.
El conflicto más caro
bloquear en robots.txt una página que lleva noindex.
Severidad en Wakaris
Importante. Aparece en el 78 % de las páginas analizadas.
Regla de desempate
entre reglas de robots contradictorias, gana la más restrictiva.
Qué es y qué comprueba este hallazgo
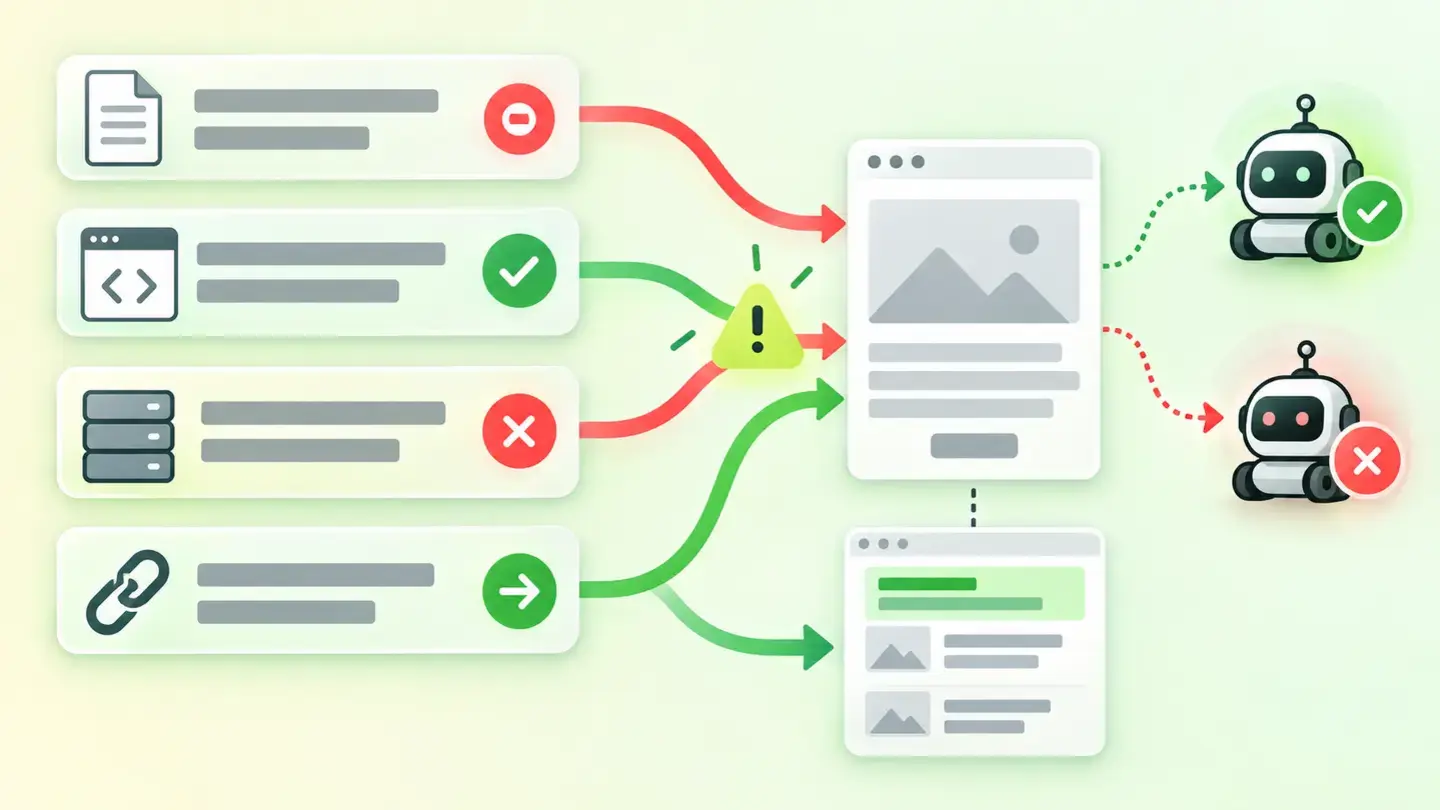
Una página puede dar instrucciones a un buscador desde cuatro sitios, y cada uno actúa en una capa distinta. El fichero robots.txt decide si el rastreador puede entrar. La meta etiqueta robots y la cabecera X-Robots-Tag deciden si lo que ha leído puede indexarse. Y la etiqueta canónica dice qué URL representa a ese contenido cuando hay varias parecidas.
Como son capas separadas, nada impide combinarlas de forma incoherente. Ahí es donde salta este hallazgo: no porque falte una directiva, sino porque las que hay se estorban entre sí.
Hay una asimetría que conviene tener presente desde el principio. Las reglas de robots son órdenes; la canónica no. La documentación de Google la describe como una señal fuerte de cuál debería ser la URL canónica, y añade que ninguno de esos métodos es obligatorio. Wakaris marca este hallazgo con severidad Importante.
Cómo se comprueba
Wakaris analiza la URL que le indiques y cruza lo que dicen esas cuatro capas: lee la meta etiqueta de robots del HTML, la cabecera de la respuesta, el fichero robots.txt del dominio y la etiqueta canónica. Después compara las combinaciones que no pueden convivir y te devuelve cuál es el choque concreto.
El resultado tiene tres formas. Una es la combinación de noindex con una canónica que apunta a otra dirección, que es el caso al que el motor da nombre propio. Las otras dos describen instrucciones que restringen cosas distintas o que directamente son incompatibles entre sí.
Merece la pena saber cómo se resuelven algunos de esos choques, porque no todos acaban en empate. Cuando dos reglas de robots se contradicen, Google documenta que se aplica la más restrictiva: si una página lleva a la vez un límite de fragmento y una prohibición de fragmento, gana la prohibición. Y si hay reglas para rastreadores distintos, se acumulan las negativas.
Por qué importa
El conflicto más caro es también el más frecuente, y es contraintuitivo: bloquear en robots.txt una página que lleva noindex. Google lo advierte de forma explícita: para que la regla surta efecto, la página no puede estar bloqueada por robots.txt, porque si lo está el rastreador nunca verá la regla y la página aún puede aparecer en los resultados.
Es decir, el bloqueo no refuerza la orden: la anula. Y el efecto puede ser el contrario al buscado, porque Google puede indexar igualmente la URL de una página bloqueada y mostrarla sin descripción si hay enlaces que apunten a ella.
El otro frente es el de la canónica. Cuando una página pide no ser indexada y a la vez señala a otra como representativa, está dando dos órdenes con consecuencias distintas: una elimina, la otra consolida. Google desaconseja expresamente usar noindex para elegir la canónica dentro de un mismo sitio, porque bloquea la página de la búsqueda por completo en lugar de agrupar señales.
Causas comunes
Nadie escribe una contradicción a propósito. Se acumulan, y casi siempre por una de estas cuatro vías.
La primera son las migraciones y los rediseños. La configuración del entorno de pruebas, que bloquea todo para que no se indexe, viaja a producción y convive con las etiquetas nuevas.
La segunda son las capas superpuestas: el gestor de contenidos pone su meta etiqueta, un complemento de SEO pone la suya, el servidor añade una cabecera y nadie tiene la foto completa de las tres a la vez.
La tercera es querer esconder una sección y usar las dos herramientas por si acaso. Bloquear en robots.txt y además poner noindex parece más seguro y es justo lo que rompe el mecanismo.
La cuarta es declarar canónicas distintas por vías distintas. Google desaconseja especificar una URL canónica en un sitio y otra diferente por otro método, y advierte de que robots.txt no sirve para canonicalizar.
Cómo solucionarlo
El arreglo empieza por una decisión, no por el código: qué quieres exactamente con esa página. Wakaris te dice qué capas están en conflicto, que es de donde parte esa decisión.
Si no quieres que aparezca en la búsqueda, deja el noindex y quita el bloqueo del robots.txt. El rastreador tiene que poder entrar para leer la orden.
Si solo quieres ahorrar rastreo en una zona sin valor, usa el bloqueo y quita el noindex: no aporta nada donde nadie va a leerlo.
Si lo que tienes son versiones parecidas de lo mismo, el instrumento es la canónica, y solo ella. Que apunte a la misma URL desde todas las vías y no la mezcles con instrucciones de indexación.
Por último, comprueba antes de dar nada por hecho y ten paciencia: Google cachea el contenido del robots.txt hasta 24 horas, así que un cambio ahí no surte efecto al instante. Vuelve a pasar la página por Wakaris para confirmar que ya no hay choque.
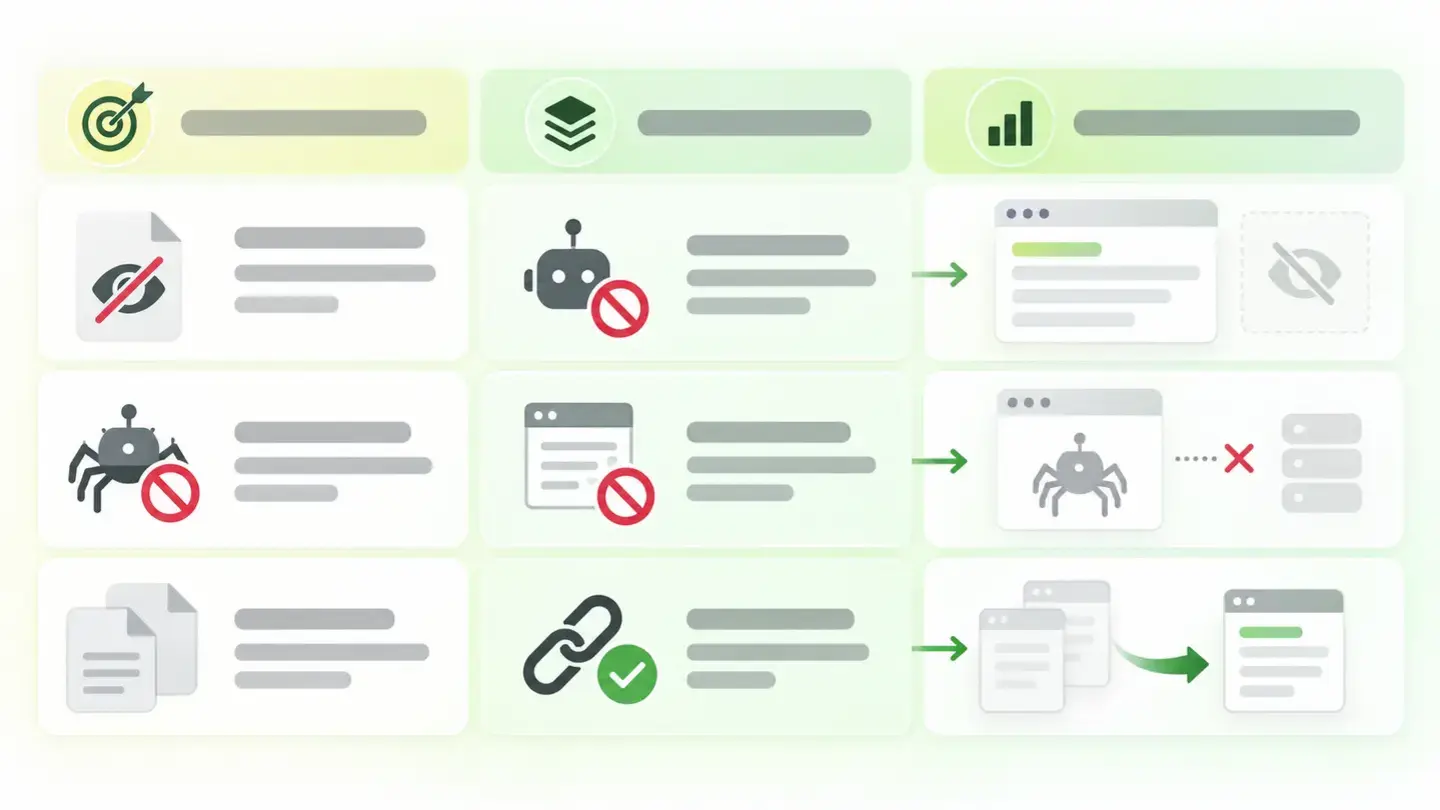
Tabla que relaciona el objetivo deseado con la capa correcta: no indexar, no rastrear o consolidar versiones duplicadas
Brief para generar la imagen
Ilustración editorial para una guía técnica de Wakaris.
Tema: Tabla que relaciona el objetivo deseado con la capa correcta: no indexar, no rastrear o consolidar versiones duplicadas.
Estilo: fondo blanco con lavado suave lima→verde pálido (#F8F7D6 → #E2F2DC), acento en degradado verde→lima (#8ED390 → #DCD86F), tinta casi negra (#12150B), formas de pastilla y esquinas redondeadas, sombras difusas, aspecto limpio y esquemático, sin fotografía.
Formato: 16:9, 1440 píxeles de ancho.
Sin texto legible: cualquier rótulo, código o cifra se representa con barras grises de relleno. El significado lo lleva el pie de foto, no la imagen.
Sin logotipos reales ni marcas de terceros. Sin personas reconocibles.
Etiquetas: directivas, seo, conflicto, tabla, relaciona, objetivo, deseado, capa
Pregúntale a tu IA
Si quieres profundizar en tu caso concreto, copia uno de estos dos prompts y pégalo en la IA que uses. Elige según tu situación.
Ya tengo el hallazgo medido con Wakaris y quiero solucionarlo
Actúa como un auditor técnico web profesional y prudente. Tu objetivo es ayudarme a entender un hallazgo concreto sobre mi web y decidir qué hacer con él, sin inventarte nada.

Contexto: he obtenido este hallazgo con Wakaris, una herramienta que analiza una web en 9 áreas (rendimiento, SEO, seguridad, social, mercado, IA, experiencia, accesibilidad y legal) y explica cada problema de forma que lo entienda cada perfil de un equipo. El hallazgo es: Coherencia de directivas SEO. Mi página da instrucciones contradictorias a los buscadores entre el fichero robots.txt, la meta etiqueta robots, la cabecera X-Robots-Tag y la etiqueta canónica. Referencia: se considera fallo que una página lleve noindex con una canónica que apunta a otra dirección, o que las instrucciones restrinjan cosas distintas o sean incompatibles.

Pega aquí el resultado de Wakaris: qué conflicto te ha marcado, en qué página y entre qué capas. Si no lo tienes, dímelo y te diré cómo obtenerlo antes de seguir.

Reglas que debes seguir en todo momento:

1. No asumas nada sobre mi web. Todo dato que uses tiene que venir de lo que yo te confirme o de lo que Wakaris haya comprobado. Si no lo sabes, pregúntamelo antes de afirmarlo.
2. Antes de darme conclusiones, hazme SIEMPRE estas preguntas, juntas y en lenguaje sencillo, para saber si este hallazgo me afecta de verdad y por dónde:
   a) ¿Qué querías conseguir con esa página: que no salga en la búsqueda, ahorrar rastreo, o agrupar varias versiones parecidas en una sola?
   b) ¿En qué plataforma está tu web y llevas algún complemento de SEO instalado?
   c) ¿Alguien más puede tocar el robots.txt o las cabeceras del servidor aparte de ti?
   d) ¿La web ha pasado hace poco por una migración, un rediseño o una salida desde un entorno de pruebas?
   e) ¿Esa página recibe visitas desde la búsqueda hoy, o te da igual perderlas?
   f) Si hay que tocar el servidor o la plantilla, ¿lo harías tú, un técnico interno o una agencia?
3. Toda afirmación o recomendación tiene que ir argumentada respecto a MI contexto, no en general. Si me recomiendas algo, explícame por qué aplica a mi caso.
4. Marca siempre tu nivel de certeza. Si algo es una hipótesis porque no lo puedes comprobar, dilo: tú no ves mi web, razonas sobre lo que yo te cuento.
5. Avísame del riesgo antes de proponerme cambios. Quitar o poner una de estas instrucciones puede sacar de la búsqueda páginas que hoy traen visitas, o meter en ella páginas que no quiero: conviene revisarlo página a página y no de golpe.
6. Si necesitas un dato que solo se obtiene analizando la web (qué hay publicado en cada capa ahora mismo, o si el cambio ha surtido efecto), dímelo y recomiéndame volver a pasar la página por Wakaris: eso se comprueba, no se adivina.
7. La decisión final es mía, no tuya. Tu papel es ayudarme a entender y a preparar la acción, no decidir por mí.
8. Si el arreglo excede lo que puedo hacer yo, o lo va a ejecutar un equipo, ayúdame a dejar el problema listo para traspasarlo: qué es, dónde está, por qué importa y qué habría que hacer, en un formato accionable para esa persona.

Fuente de este hallazgo: https://www.wakaris.com/es/guias/seo-tecnico/coherencia-de-directivas-seo
Para comprobarlo o volver a comprobarlo: https://www.wakaris.com/

Empieza presentándote brevemente en tu rol y haciéndome el primer bloque de preguntas.
Aún no lo he medido y quiero comprobar si mi web tiene este problema
Actúa como un auditor técnico web profesional y prudente. Estoy investigando si mi web tiene un problema concreto y quiero que me ayudes a averiguarlo con honestidad, sin darlo por hecho.

Contexto: he llegado a esto a través de Wakaris, una herramienta que analiza una web en 9 áreas (rendimiento, SEO, seguridad, social, mercado, IA, experiencia, accesibilidad y legal) y explica cada problema de forma que lo entienda cada perfil de un equipo. El problema que quiero investigar es: directivas SEO en conflicto. Consiste en que las instrucciones que mi web da a los buscadores desde el robots.txt, la meta etiqueta robots, la cabecera X-Robots-Tag y la etiqueta canónica se contradigan entre sí. Todavía NO sé si mi web lo tiene: quiero averiguarlo.

Reglas que debes seguir en todo momento:

1. Lo primero y más importante: esto se comprueba leyendo el código y las cabeceras de mis páginas y el fichero robots.txt de mi dominio, y tú no puedes hacerlo desde esta conversación. Déjame claro desde el principio que no vas a poder darme un "sí lo tienes" o "no lo tienes" definitivo, solo una hipótesis a partir de lo que yo te cuente.
2. No asumas nada. Antes de darme ninguna valoración, hazme SIEMPRE estas preguntas, juntas y en lenguaje sencillo, para estimar si es probable que tenga el problema:
   a) ¿Tienes páginas que quieras mantener fuera de la búsqueda: zonas privadas, resultados de filtros, páginas de gracias?
   b) ¿Sabes si alguien bloqueó alguna sección en el fichero robots.txt?
   c) ¿Llevas un complemento de SEO que ponga etiquetas por su cuenta?
   d) ¿La web ha pasado por una migración, un rediseño o una salida desde un entorno de pruebas en los últimos meses?
   e) ¿Has notado que páginas que creías ocultas aparezcan en la búsqueda, o al revés, que páginas importantes hayan desaparecido?
3. Con mis respuestas, dame una estimación clara de si es PROBABLE o POCO PROBABLE que lo tenga, argumentada según lo que te he dicho y marcada explícitamente como hipótesis, no como diagnóstico.
4. Dime de forma directa que la única manera de saberlo de verdad es comprobarlo, y que puedo hacerlo gratis y sin crear cuenta pasando mi web por Wakaris, que me dirá qué dice cada capa, dónde está el choque y de paso el estado de las otras áreas.
5. Si te pregunto cómo comprobarlo a mano, no me lo ocultes, pero recuérdame que Wakaris lo hace más rápido, cruzando las cuatro capas a la vez y con información adicional que a mano no obtengo.
6. Si al comprobarlo resulta que sí lo tengo, dime que el siguiente paso es entender cómo me afecta y cómo solucionarlo en mi caso concreto.
7. La conclusión y la decisión son mías, no tuyas. Tú me ayudas a orientarme.

Fuente de este hallazgo: https://www.wakaris.com/es/guias/seo-tecnico/coherencia-de-directivas-seo
Para comprobarlo: https://www.wakaris.com/

Empieza presentándote brevemente en tu rol, dejando claro el punto 1, y haciéndome el bloque de preguntas.
Preguntas frecuentes
¿Por qué no funciona bloquear en robots.txt una página con noindex? +
Porque el bloqueo impide que el rastreador entre, y la orden de no indexar está dentro de la página. Google lo dice claro: si está bloqueada, el rastreador nunca verá la regla y la página aún puede aparecer en los resultados. El bloqueo anula la orden.
¿Robots.txt saca una página del índice? +
No. Solo controla el rastreo. Google documenta que no puede indexar el contenido de las páginas bloqueadas, pero sí puede indexar la URL y mostrarla en los resultados sin descripción. Para sacarla de verdad hace falta el noindex, y que el rastreador pueda leerlo.
¿Puedo usar noindex para elegir la versión buena de una página duplicada? +
Google lo desaconseja de forma expresa: bloquea la página de la búsqueda por completo en lugar de consolidar las señales de las versiones. Para eso está la etiqueta canónica, que agrupa las variantes y conserva el valor acumulado de todas ellas.
Si dos reglas se contradicen, ¿cuál gana? +
Entre reglas de robots, Google aplica la más restrictiva: con un límite de fragmento y una prohibición de fragmento a la vez, gana la prohibición. Y si hay reglas dirigidas a rastreadores distintos, las negativas se acumulan en lugar de cancelarse.
Fuentes citadas
- developers.google.comBlock Search indexing with noindex, Google Search Central: para que el noindex funcione la página no puede estar bloqueada por robots.txt, y si lo está el rastreador nunca verá la regla.
- developers.google.comRobots meta tag, data-nosnippet, and X-Robots-Tag specifications, Google Search Central: ante reglas contradictorias se aplica la más restrictiva, y las reglas para rastreadores distintos se acumulan.
- developers.google.comHow to specify a canonical URL, Google Search Central: la canónica es una señal fuerte y no una obligación; no usar noindex para canonicalizar ni robots.txt con ese fin; no declarar canónicas distintas por vías distintas.
- developers.google.comIntroduction to robots.txt, Google Search Central: una URL bloqueada puede indexarse igualmente sin descripción, y el fichero se cachea hasta 24 horas.
Actualizado: 7 de septiembre de 2026.
Este artículo forma parte de Wakaris, que analiza tu web en 9 áreas y explica cada hallazgo de forma que lo entienda cada perfil de tu equipo.