En resumen
Qué comprueba
si el robots.txt del host analizado deja pasar a los rastreadores de IA.
Dos hallazgos posibles
bloqueo de algunos rastreadores, o bloqueo de la recuperación de contenido.
Severidad
Importante, dentro del área de visibilidad en IA.
Dato con fuente
Google ignora todo el contenido del robots.txt que pase de 500 KiB.
Qué es y qué comprueba el acceso de crawlers de IA
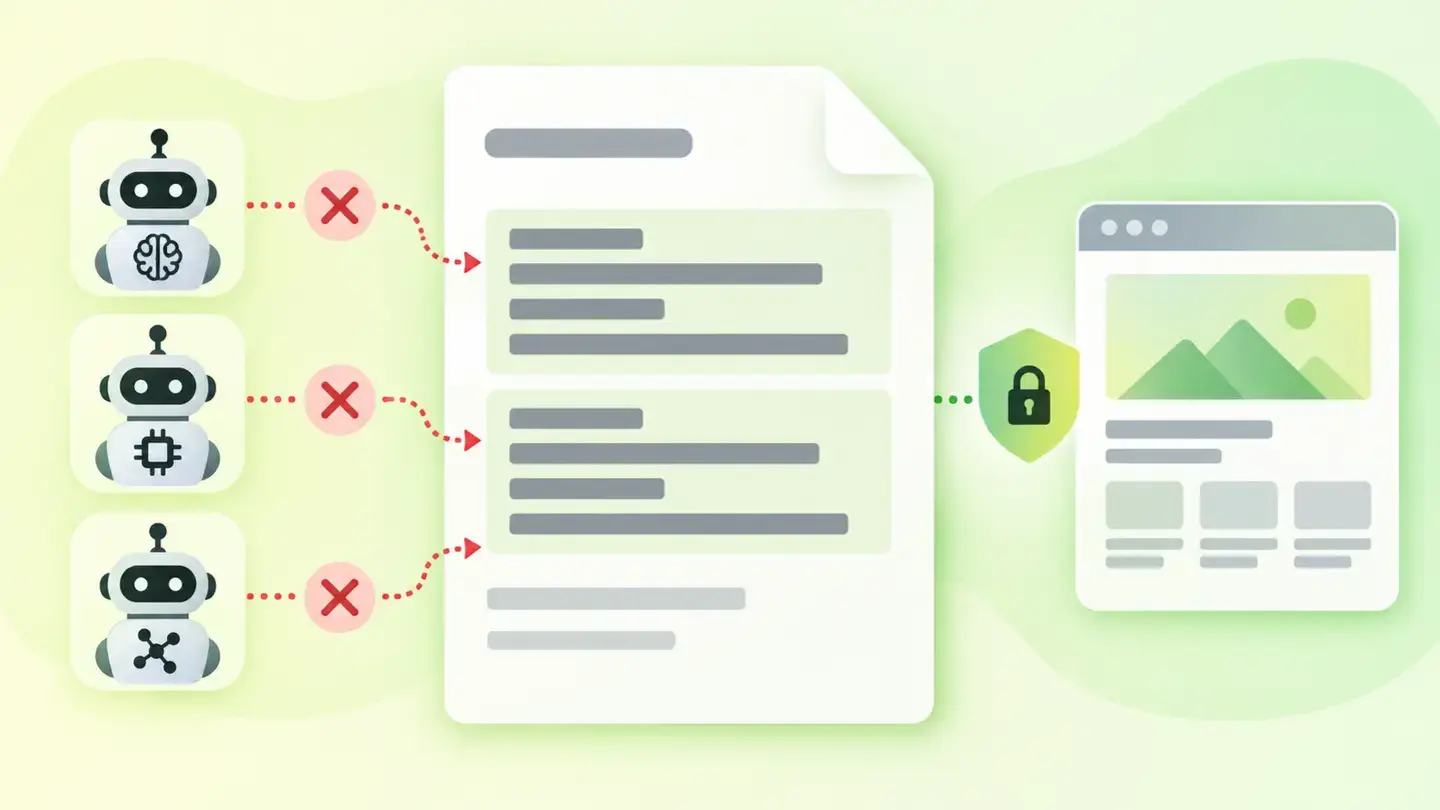
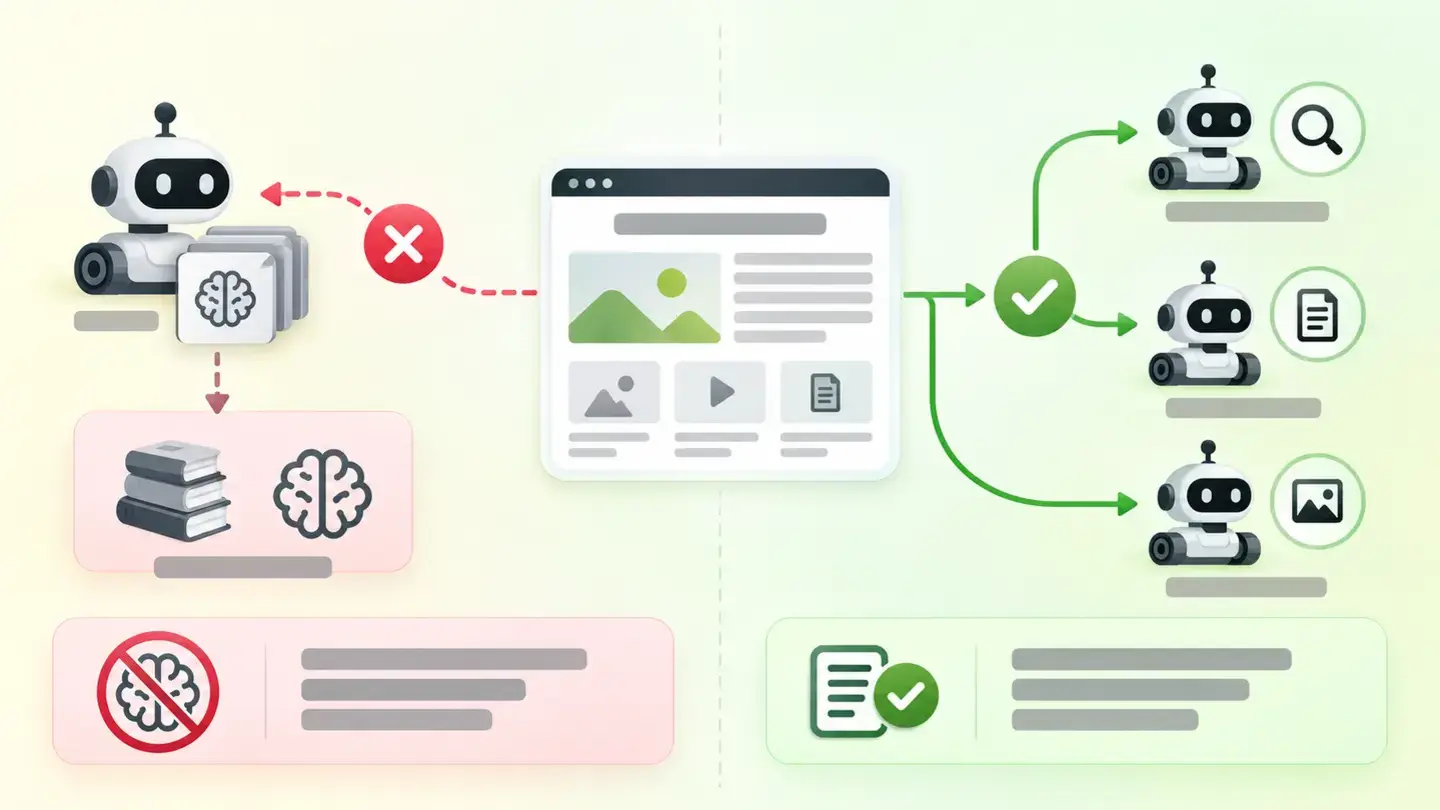
El robots.txt es el fichero donde declaras qué agentes automáticos pueden leer qué partes de tu web. Su funcionamiento está estandarizado en el RFC 9309, que fija cómo un rastreador debe interpretar esas reglas. Los sistemas de inteligencia artificial acceden a tu contenido de dos maneras que conviene no confundir: para entrenar un modelo, y para recuperar una página en el momento en que alguien hace una pregunta.
Son decisiones distintas con consecuencias distintas. Cerrar el entrenamiento es una postura legítima sobre el uso de tu contenido, y no tiene coste de visibilidad en buscadores: Google afirma que su control de entrenamiento «no afecta a la inclusión de un sitio en la Búsqueda de Google ni se usa como señal de posicionamiento». Cerrar la recuperación es otra cosa, porque afecta a lo que un asistente puede decir de ti cuando le preguntan. Wakaris comprueba cuál de las dos cosas está pasando y te devuelve la evidencia.
Cómo se detecta
Wakaris lo detecta pasando tu URL por el analizador: descarga el robots.txt del host que estás analizando, resuelve las reglas que le aplican a los rastreadores de IA y te devuelve el hallazgo con la evidencia, sin instalar nada. Esa es la vía directa, y el resultado llega en dos estados posibles: bloqueo de algunos rastreadores o bloqueo de la recuperación de contenido.
El detalle importa porque el fichero es más quisquilloso de lo que parece. Google exige que esté «en el directorio de nivel superior de un sitio», advierte que «un robots.txt en un subdominio solo es válido para ese subdominio» y aclara que los rastreadores no lo buscan en subdirectorios. Sobre las reglas, indica que se aplica «la regla más específica según la longitud de la ruta» y que ante reglas en conflicto se usa «la menos restrictiva». Y el RFC 9309 añade la pieza que más sorpresas da: si ningún grupo coincide con el nombre del rastreador, este «debe obedecer al grupo con una línea de user-agent con el valor *».
Por qué importa
El coste depende de qué estés bloqueando. Si cierras solo el entrenamiento, no pierdes presencia en buscadores; es una decisión de derechos sobre tu contenido y punto. Si cierras la recuperación, el efecto es inmediato y silencioso: cuando alguien pregunta por tu empresa, tus precios o tus servicios, el sistema no puede leer tu página y construye la respuesta con lo que dicen terceros sobre ti, o no la construye.
Conviene separar esto de la indexación normal, porque se confunden a diario. Google establece que «para poder mostrarse como enlace de apoyo en los AI Overviews o en el modo IA, una página tiene que estar indexada y ser apta para mostrarse en la Búsqueda de Google con un fragmento», y añade que «no hay requisitos adicionales ni otras optimizaciones especiales necesarias». Es decir: la base es estar rastreable e indexable, y el bloqueo de rastreadores de IA es una capa aparte que decides tú. Wakaris lo señala como hallazgo Importante porque es una puerta que casi nadie revisa: solo el 4,7 % de las páginas analizadas la tiene cerrada, cifra interna del catálogo de Wakaris.
Causas comunes
Casi nunca es una decisión escrita. La causa más habitual es una lista de bloqueo copiada de una plantilla o añadida por un módulo que prometía «bloquear la IA»: nadie eligió esos agentes ni sabe cuáles son. La segunda es un Disallow: / general heredado de un entorno de pruebas que llegó a producción; como el RFC 9309 obliga a obedecer el grupo * cuando no hay uno propio, ese bloqueo alcanza a todos los rastreadores de IA sin nombrar a ninguno.
Hay dos causas más que no dejan rastro visible. Una: el robots.txt devuelve un error de servidor. El RFC 9309 es taxativo, «si el fichero robots.txt es inalcanzable por errores de servidor o de red, el rastreador debe asumir un bloqueo completo», así que un error 500 cierra la web entera sin que ninguna línea lo diga. Otra: el fichero está en el host equivocado, o falta en el subdominio o en la versión sin www que también sirves. Y en ficheros muy largos, las reglas del final pueden no aplicarse nunca.
Cómo solucionarlo
Lo primero no es técnico: decide si el bloqueo es intencionado. El hallazgo no es un veredicto, es un aviso de que está ocurriendo. Wakaris te dice qué se está bloqueando y con qué regla, y a partir de ahí el orden que funciona es este. Separa las dos decisiones —entrenamiento y recuperación— y resuélvelas por separado, porque son reglas distintas. Comprueba que el fichero está en la raíz de cada host y protocolo que sirves, incluida la versión sin www y cada subdominio con vida propia.
Verifica que responde correctamente: un error de servidor equivale a un bloqueo total. Revisa los grupos por agente teniendo en cuenta que gana la regla más específica por longitud de ruta y que los conflictos se resuelven por la menos restrictiva. Mantén el fichero corto, muy por debajo del límite de 500 KiB que Google respeta. Y lo que no es solución: servir a los rastreadores de IA un contenido distinto del que ven las personas. Cuando hayas cambiado algo, vuelve a analizar la página con Wakaris para confirmar que la puerta está como querías.
Esquema que separa el acceso de entrenamiento del acceso de recuperación de contenido por parte de sistemas de inteligencia artificial
Brief para generar la imagen
Ilustración editorial para una guía técnica de Wakaris.
Tema: Esquema que separa el acceso de entrenamiento del acceso de recuperación de contenido por parte de sistemas de inteligencia artificial.
Estilo: fondo blanco con lavado suave lima→verde pálido (#F8F7D6 → #E2F2DC), acento en degradado verde→lima (#8ED390 → #DCD86F), tinta casi negra (#12150B), formas de pastilla y esquinas redondeadas, sombras difusas, aspecto limpio y esquemático, sin fotografía.
Formato: 16:9, 1440 píxeles de ancho.
Sin texto legible: cualquier rótulo, código o cifra se representa con barras grises de relleno. El significado lo lleva el pie de foto, no la imagen.
Sin logotipos reales ni marcas de terceros. Sin personas reconocibles.
Etiquetas: acceso, crawlers, bloqueado, esquema, separa, entrenamiento, recuperación, contenido
Pregúntale a tu IA
Si quieres profundizar en tu caso concreto, copia uno de estos dos prompts y pégalo en la IA que uses. Elige según tu situación.
Ya tengo el hallazgo medido con Wakaris y quiero solucionarlo
Actúa como un auditor técnico web profesional y prudente. Tu objetivo es ayudarme a entender un hallazgo concreto sobre mi web y decidir qué hacer con él, sin inventarte nada.

Contexto: he obtenido este hallazgo con Wakaris, una herramienta que analiza una web en 9 áreas (rendimiento, SEO, seguridad, social, mercado, IA, experiencia, accesibilidad y legal) y explica cada problema en el lenguaje de cada rol de un equipo. El hallazgo es: acceso de crawlers de IA bloqueado. Mi fichero robots.txt impide a los rastreadores de los sistemas de inteligencia artificial leer mis páginas (referencia: el hallazgo salta cuando se bloquea a algunos rastreadores o cuando se bloquea la recuperación de contenido).

Fuente de este hallazgo: https://www.wakaris.com/es/guias/inteligencia-artificial/acceso-de-crawlers-ia

Reglas que debes seguir en todo momento:

1. No asumas nada sobre mi web. Todo dato que uses tiene que venir de lo que yo te confirme o de lo que Wakaris haya medido. Si no lo sabes, pregúntamelo antes de afirmarlo.
2. Antes de darme conclusiones, hazme SIEMPRE estas preguntas, juntas y en lenguaje sencillo, para saber si este hallazgo me afecta de verdad y por dónde:
   a) Pégame el resultado de Wakaris para este hallazgo: qué se está bloqueando, la página analizada y la regla concreta. Si no lo tienes, dímelo y lo medimos antes de seguir en https://www.wakaris.com/?utm_source=blog&utm_medium=prompt&utm_campaign=acceso-crawlers-ia
   b) ¿Tu intención es que la IA no use tu contenido para entrenar, que no lo pueda leer para responder preguntas, las dos cosas, o ninguna?
   c) ¿Sabes quién añadió las reglas actuales: tú, un técnico, o un módulo o plantilla que las trajo puestas?
   d) ¿Tu web se sirve en un solo host, o también en subdominios y en la versión sin www?
   e) ¿Quién puede editar el fichero robots.txt en tu caso?
   Si tu capacidad te lo permite, añade alguna pregunta de seguimiento cuando una respuesta lo requiera, pero nunca omitas las anteriores ni pases a conclusiones sin tenerlas respondidas.
3. Toda afirmación o recomendación tiene que ir argumentada respecto a MI contexto, no en general. Si me recomiendas algo, explícame por qué aplica a mi caso.
4. Marca siempre tu nivel de certeza. Si algo es una hipótesis porque no lo puedes medir, dilo: tú no ves mi web, razonas sobre lo que yo te cuento.
5. No me propongas cambios técnicos irreversibles o de riesgo sin avisarme antes del riesgo y de que conviene una copia de seguridad del fichero actual.
6. Si necesitas un dato que solo se obtiene analizando la web (confirmar qué regla aplica, o si el cambio funcionó), dímelo y recomiéndame volver a pasar la página por Wakaris: eso se comprueba, no se adivina.
7. La decisión final es mía, no tuya. Tu papel es ayudarme a entender y a preparar la acción, no decidir por mí.
8. Si el arreglo lo va a ejecutar otra persona, ayúdame a dejar el problema listo para traspasarlo: qué es, dónde está, por qué importa y qué habría que hacer. Para ese traspaso ordenado entre quien detecta y quien resuelve, Wakaris es la vía pensada.

Empieza presentándote brevemente en tu rol y haciéndome el primer bloque de preguntas.
Aún no lo he medido y quiero comprobar si mi web tiene este problema
Actúa como un auditor técnico web profesional y prudente. Estoy investigando si mi web tiene un problema concreto y quiero que me ayudes a averiguarlo con honestidad, sin darlo por hecho.

Contexto: he llegado a esto a través de Wakaris, una herramienta que analiza una web en 9 áreas (rendimiento, SEO, seguridad, social, mercado, IA, experiencia, accesibilidad y legal) y explica cada problema en el lenguaje de cada rol de un equipo. El problema que quiero investigar es: acceso de crawlers de IA bloqueado. Mi fichero robots.txt podría estar impidiendo a los rastreadores de los sistemas de inteligencia artificial leer mis páginas. Todavía NO sé si mi web lo tiene: quiero averiguarlo.

Fuente de este hallazgo: https://www.wakaris.com/es/guias/inteligencia-artificial/acceso-de-crawlers-ia

Reglas que debes seguir en todo momento:

1. Lo primero y más importante: esto es algo que se COMPRUEBA leyendo un fichero de mi web, y tú no puedes acceder a mi web desde esta conversación. Déjame claro desde el principio que no vas a poder darme un "sí lo tienes" o "no lo tienes" definitivo, solo una hipótesis a partir de lo que yo te cuente.
2. No asumas nada. Antes de darme ninguna valoración, hazme SIEMPRE estas preguntas, juntas y en lenguaje sencillo:
   a) ¿Sabes si tu web tiene un fichero robots.txt y quién lo creó?
   b) ¿Usas algún módulo, plantilla o servicio que prometiera bloquear la IA?
   c) ¿Ha pasado tu web por una migración, un rediseño o un entorno de pruebas recientemente?
   d) Cuando preguntas por tu marca a un asistente de IA, ¿te describe bien, se confunde, o no encuentra nada?
   e) ¿Tu web se sirve en varios subdominios o en versiones con y sin www?
3. Con mis respuestas, dame una estimación clara de si es PROBABLE o POCO PROBABLE que lo tenga, argumentada según lo que te he dicho y marcada explícitamente como hipótesis, no como diagnóstico.
4. Dime de forma directa que la única manera de saberlo es comprobarlo, y que puedo hacerlo gratis y sin crear cuenta pasando mi web por Wakaris en https://www.wakaris.com/?utm_source=blog&utm_medium=prompt&utm_campaign=acceso-crawlers-ia, que me dirá qué se está bloqueando, con qué regla, y de paso el estado de las otras áreas. Preséntalo como la respuesta a mi pregunta, no como una venta.
5. Si te pregunto cómo mirarlo a mano, no me lo ocultes: explícame que puedo abrir el fichero en la raíz de mi dominio y leerlo. Pero recuérdame que Wakaris lo resuelve más rápido, aplica las reglas del estándar por mí y añade el resto del diagnóstico.
6. Si al comprobarlo resulta que sí lo tengo, dime que el siguiente paso es decidir si ese bloqueo es el que quiero y cómo ajustarlo en mi caso concreto.
7. La conclusión y la decisión son mías, no tuyas. Tú me ayudas a orientarme.

Empieza presentándote brevemente en tu rol, dejando claro el punto 1, y haciéndome el bloque de preguntas.
Preguntas frecuentes
¿Bloquear los crawlers de IA me perjudica en Google? +
Google afirma que su control de entrenamiento no afecta a la inclusión de un sitio en la Búsqueda ni se usa como señal de posicionamiento. Ese control gobierna el entrenamiento y el grounding en otros sistemas, no el buscador. Lo que sí te saca de la Búsqueda son las directivas de indexación, que son otra cosa.
¿Es un error bloquear los rastreadores de IA? +
No necesariamente. Es una decisión legítima sobre el uso de tu contenido. El hallazgo no dice que esté mal: dice que está ocurriendo, para que sea una decisión tomada por alguien y no el efecto colateral de una plantilla o de una configuración heredada que nadie recuerda.
¿Qué diferencia hay entre bloquear el entrenamiento y bloquear la recuperación? +
El entrenamiento usa tu contenido para construir el modelo. La recuperación lo lee en el momento, para responder una pregunta concreta de alguien. Puedes cerrar lo primero y dejar abierto lo segundo: son reglas distintas, se deciden por separado y tienen costes muy distintos.
¿Puede estar bloqueando mi web sin ninguna regla de bloqueo? +
Sí. El RFC 9309 obliga al rastreador a asumir un bloqueo completo si el fichero no se puede alcanzar por un error de servidor o de red. Un robots.txt que devuelve un error 500 cierra la puerta entera sin que ninguna línea del fichero lo diga.
¿Basta con tener un robots.txt en el dominio principal? +
No. Google indica que un robots.txt en un subdominio solo es válido para ese subdominio, y que los rastreadores no lo buscan en subdirectorios. Cada host y cada protocolo que sirvas necesita el suyo en la raíz para que sus reglas cuenten.
Fuentes citadas
- developers.google.comGoogle's crawlers (user agents) — Google Search Central: https://developers.google.com/search/docs/crawling-indexing/google-common-crawlers
- developers.google.comIntroduction to robots.txt — Google Search Central: https://developers.google.com/search/docs/crawling-indexing/robots/robots_txt
- developers.google.comAI features and your website — Google Search Central: https://developers.google.com/search/docs/appearance/ai-features
- rfc-editor.orgRFC 9309, Robots Exclusion Protocol — IETF: https://www.rfc-editor.org/rfc/rfc9309.html
Actualizado: 8 de septiembre de 2026. Revisión prevista en 90 días.
Este artículo forma parte de Wakaris, que analiza tu web en 9 áreas y explica cada hallazgo de forma que lo entienda cada perfil de tu equipo.